在微服務(wù)架構(gòu)中,服務(wù)數(shù)量激增、部署環(huán)境復(fù)雜,一個(gè)可靠的監(jiān)控系統(tǒng)不再是可選項(xiàng),而是保障系統(tǒng)穩(wěn)定、高效運(yùn)行的基石。它如同信息系統(tǒng)的“眼睛”和“耳朵”,是運(yùn)行維護(hù)服務(wù)的核心組成部分。本文旨在分享如何從零開始,搭建一個(gè)能夠洞察全局、快速定位問題的可靠監(jiān)控系統(tǒng)。
一、監(jiān)控系統(tǒng)的核心目標(biāo)與原則
在搭建之前,必須明確監(jiān)控的目標(biāo)不僅是“發(fā)現(xiàn)問題”,更是“預(yù)防問題”和“輔助決策”。一個(gè)可靠的監(jiān)控系統(tǒng)應(yīng)遵循以下原則:
- 全面性:覆蓋應(yīng)用、服務(wù)、容器、主機(jī)、網(wǎng)絡(luò)、中間件等所有層面。
- 實(shí)時(shí)性:數(shù)據(jù)采集、處理和告警的延遲要足夠低,以便快速響應(yīng)。
- 關(guān)聯(lián)性:能將跨服務(wù)、跨組件的指標(biāo)和日志關(guān)聯(lián)起來,形成完整的調(diào)用鏈視圖。
- 可擴(kuò)展性:能夠適應(yīng)微服務(wù)數(shù)量的動(dòng)態(tài)增長和技術(shù)的演進(jìn)。
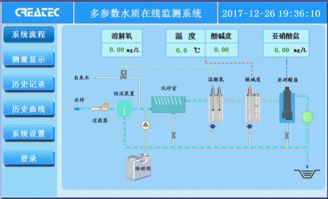
- 可視化與可操作性:數(shù)據(jù)應(yīng)以直觀的儀表盤呈現(xiàn),告警信息應(yīng)具備清晰的上下文,便于運(yùn)維人員迅速行動(dòng)。
二、監(jiān)控系統(tǒng)架構(gòu)分層搭建
一個(gè)典型的微服務(wù)監(jiān)控系統(tǒng)通常分為以下四層:
1. 數(shù)據(jù)采集層
這是監(jiān)控的源頭。需要在應(yīng)用代碼和基礎(chǔ)設(shè)施中埋點(diǎn),采集各類數(shù)據(jù):
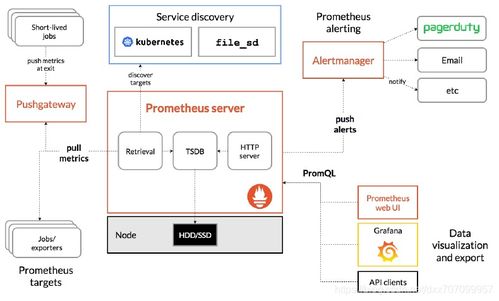
- 指標(biāo)(Metrics):如服務(wù)的QPS、響應(yīng)時(shí)間、錯(cuò)誤率、CPU/內(nèi)存使用率等。常用采集工具有Prometheus的各類Exporter、Micrometer(Java應(yīng)用)等。
- 日志(Logs):應(yīng)用程序輸出的結(jié)構(gòu)化日志(如JSON格式)。推薦使用Filebeat、Fluentd等日志采集器。
- 追蹤(Traces):記錄單個(gè)請(qǐng)求在分布式系統(tǒng)中流轉(zhuǎn)的完整路徑。可采用OpenTelemetry標(biāo)準(zhǔn),集成Jaeger或Zipkin。
2. 數(shù)據(jù)傳輸與聚合層
將分散采集的數(shù)據(jù)匯聚到中心。考慮到微服務(wù)環(huán)境的動(dòng)態(tài)性,通常需要一個(gè)輕量級(jí)的消息隊(duì)列或流處理平臺(tái)作為緩沖,如Kafka。這可以避免數(shù)據(jù)洪峰沖垮后端存儲(chǔ),并實(shí)現(xiàn)解耦。
3. 數(shù)據(jù)存儲(chǔ)與分析層
根據(jù)數(shù)據(jù)類型選擇合適的存儲(chǔ),這是系統(tǒng)可靠性的關(guān)鍵:
- 時(shí)序數(shù)據(jù)存儲(chǔ):用于存儲(chǔ)指標(biāo)數(shù)據(jù),要求具備極高的寫入和查詢效率。Prometheus TSDB是其自帶的優(yōu)秀存儲(chǔ),長期歷史數(shù)據(jù)可存入Thanos或VictoriaMetrics,亦或使用InfluxDB、TimescaleDB。
- 日志存儲(chǔ)與分析:需要強(qiáng)大的全文檢索和聚合分析能力。Elasticsearch是當(dāng)前的主流選擇,與Kibana搭配構(gòu)成強(qiáng)大的日志平臺(tái)。
- 追蹤數(shù)據(jù)存儲(chǔ):Jaeger、Zipkin均有自己的存儲(chǔ)后端,也可選擇支持OpenTelemetry的通用存儲(chǔ)。
4. 可視化與告警層
這是監(jiān)控價(jià)值的最終體現(xiàn)。
- 可視化:Grafana是目前最流行的指標(biāo)可視化工具,它能靈活地連接多種數(shù)據(jù)源(如Prometheus、Elasticsearch)創(chuàng)建豐富的儀表盤。Kibana則專注于日志和追蹤數(shù)據(jù)的可視化。
- 告警:告警規(guī)則應(yīng)分層分級(jí)。Prometheus Alertmanager可以很好地管理基于指標(biāo)的告警規(guī)則,進(jìn)行分組、抑制和路由(如發(fā)送到釘釘、企業(yè)微信、PagerDuty)。對(duì)于日志和追蹤中的模式匹配告警,可使用ElastAlert或Grafana的告警功能。
三、關(guān)鍵技術(shù)棧選型與集成示例
一個(gè)經(jīng)典、高性價(jià)比的開源監(jiān)控技術(shù)棧組合是:
- 指標(biāo)監(jiān)控:Prometheus + Grafana
- 日志監(jiān)控:ELK/EFK Stack (Elasticsearch, Logstash/Fluentd, Kibana)
- 分布式追蹤:Jaeger 或 Zipkin
- 基礎(chǔ)設(shè)施監(jiān)控:Node Exporter (主機(jī)), cAdvisor (容器)
所有應(yīng)用應(yīng)通過OpenTelemetry SDK進(jìn)行埋點(diǎn),統(tǒng)一采集指標(biāo)、日志和追蹤信號(hào),并將其導(dǎo)出到對(duì)應(yīng)的后端。
四、構(gòu)建可靠性的關(guān)鍵實(shí)踐
- 監(jiān)控系統(tǒng)自身需要被監(jiān)控:用另一套獨(dú)立的、更輕量的監(jiān)控系統(tǒng)來監(jiān)控核心的監(jiān)控組件(如Prometheus、Elasticsearch集群的健康狀態(tài)),避免出現(xiàn)“監(jiān)控盲區(qū)”。
- 定義清晰的SLO/SLI:基于業(yè)務(wù)目標(biāo)定義服務(wù)等級(jí)目標(biāo)(SLO)和指標(biāo)(SLI),如“API接口99.9%的請(qǐng)求延遲低于200ms”。監(jiān)控應(yīng)圍繞SLO展開,告警應(yīng)在SLO可能被違反前觸發(fā)。
- 告警的“黃金信號(hào)”與智能化:重點(diǎn)關(guān)注流量、延遲、錯(cuò)誤和飽和度這四大黃金信號(hào)。逐步引入基于機(jī)器學(xué)習(xí)的異常檢測(cè)(如使用Prometheus的Prometheus ML或外接工具),減少誤報(bào)和噪音。
- 建立完善的On-Call與故障響應(yīng)流程:可靠的監(jiān)控必須配合有效的人員流程。告警應(yīng)能自動(dòng)分派到責(zé)任人,并附帶清晰的排障指引和上下文(如關(guān)聯(lián)的日志、變更記錄)。
- 容量規(guī)劃與高可用部署:監(jiān)控?cái)?shù)據(jù)量會(huì)快速增長,必須對(duì)存儲(chǔ)進(jìn)行容量規(guī)劃。核心組件如Prometheus、Alertmanager、Elasticsearch都應(yīng)以集群模式部署,確保高可用。
五、
搭建一個(gè)可靠的微服務(wù)監(jiān)控系統(tǒng)是一個(gè)持續(xù)迭代的過程,而非一蹴而就的項(xiàng)目。它始于清晰的監(jiān)控目標(biāo),成于分層、可擴(kuò)展的技術(shù)架構(gòu),最終固化為團(tuán)隊(duì)日常運(yùn)維的流程與文化。從核心業(yè)務(wù)指標(biāo)和基礎(chǔ)設(shè)施健康度入手,逐步完善日志、追蹤等可觀測(cè)性支柱,最終構(gòu)建起一個(gè)能夠預(yù)測(cè)風(fēng)險(xiǎn)、快速定位、輔助優(yōu)化的立體監(jiān)控體系,這才是微服務(wù)時(shí)代信息系統(tǒng)運(yùn)行維護(hù)服務(wù)的堅(jiān)實(shí)保障。
(本文為學(xué)習(xí)筆記與實(shí)踐,技術(shù)選型僅供參考,請(qǐng)根據(jù)實(shí)際場(chǎng)景評(píng)估決策。)